Chuyên mục
Phân tích dữ liệu với Python
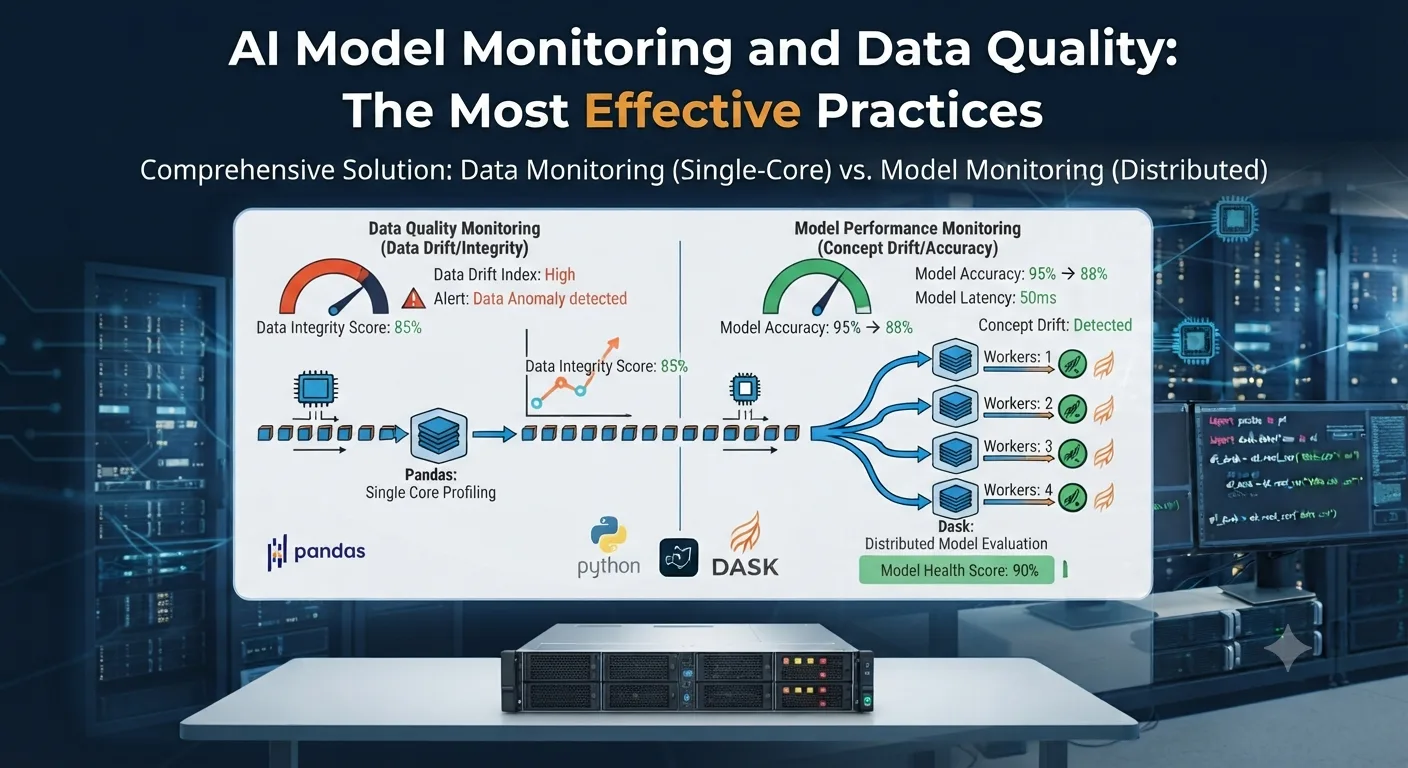
Hướng dẫn giám sát mô hình AI và chất lượng dữ liệu với Python hiệu quả nhất
Việc triển khai một mô hình Machine Learning lên môi trường production chỉ mới là bước khởi đầu của vòng đời sản phẩm AI. Thách thức lớn nhất đối với các kỹ sư dữ liệu và nhà khoa học dữ liệu nằm ở việc duy trì độ chính xác của mô hình trước các biến động thực tế của môi trường kinh doanh. Hiện tượng data drift (sự dịch chuyển dữ liệu) và concept drift (sự dịch chuyển khái niệm) có thể làm sụt giảm nghiêm trọng hiệu suất mô hình nếu không được phát hiện kịp thời. Ngôn ngữ Python cung cấp một hệ sinh thái thư viện phong phú giúp tự động hóa toàn bộ quy trình này một cách mượt mà.
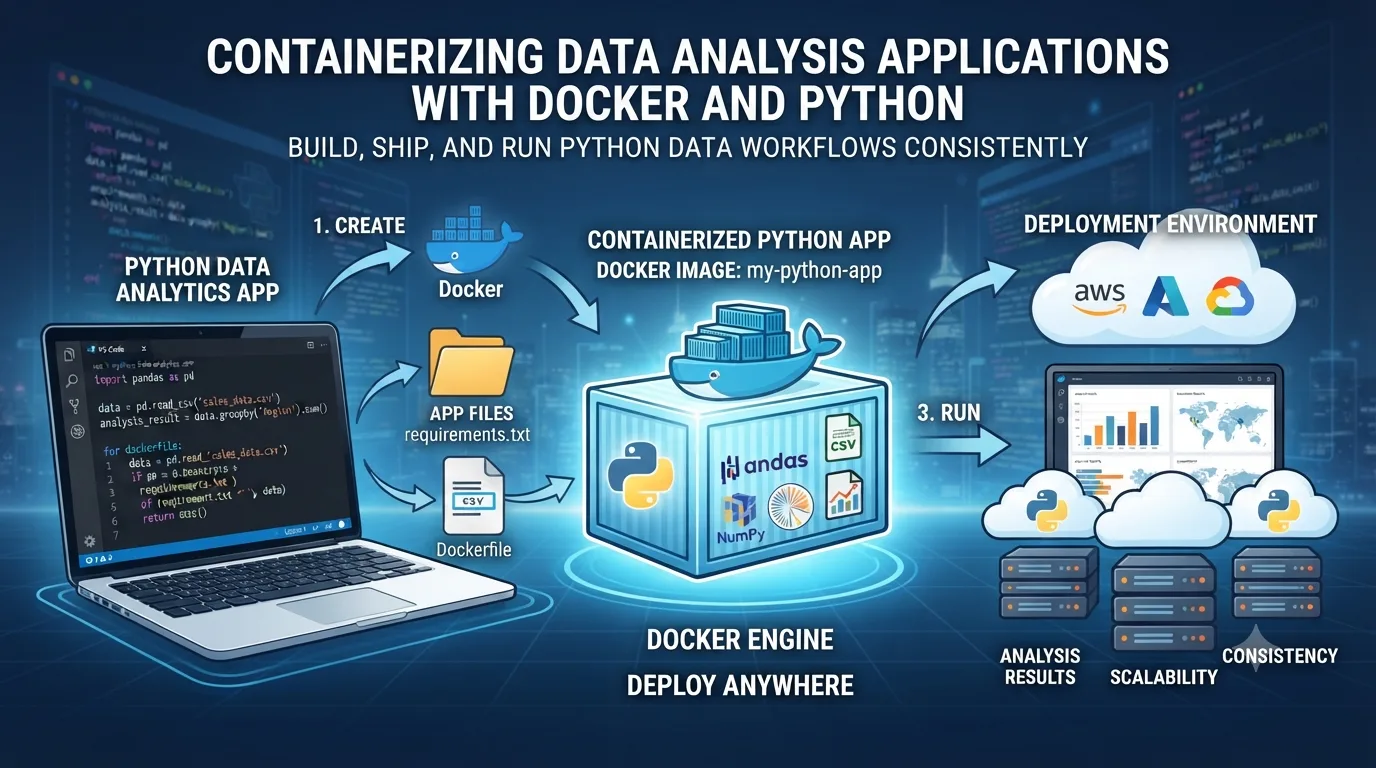
Container Hóa Ứng Dụng Phân Tích Dữ Liệu Với Docker Và Ngôn Ngữ Python
Trong thế giới phát triển phần mềm hiện đại, việc xây dựng một hệ thống phân tích dữ liệu xuất sắc chỉ là bước đi đầu tiên. Thách thức lớn nhất của các lập trình viên và kỹ sư dữ liệu thường nằm ở câu hỏi kinh điển: "Tại sao mã nguồn chạy mượt mà trên máy tính cá nhân nhưng lại lỗi khi đưa lên máy chủ sản xuất (production)?". Sự khác biệt về môi trường, phiên bản thư viện hay hệ điều hành chính là thủ phạm. Đây là lúc Docker xuất hiện như một cứu cánh tuyệt vời, giúp đóng gói toàn bộ ứng dụng ngôn ngữ Python cùng các phụ thuộc vào bên trong một môi trường cô lập, di động và ổn định tuyệt đối.
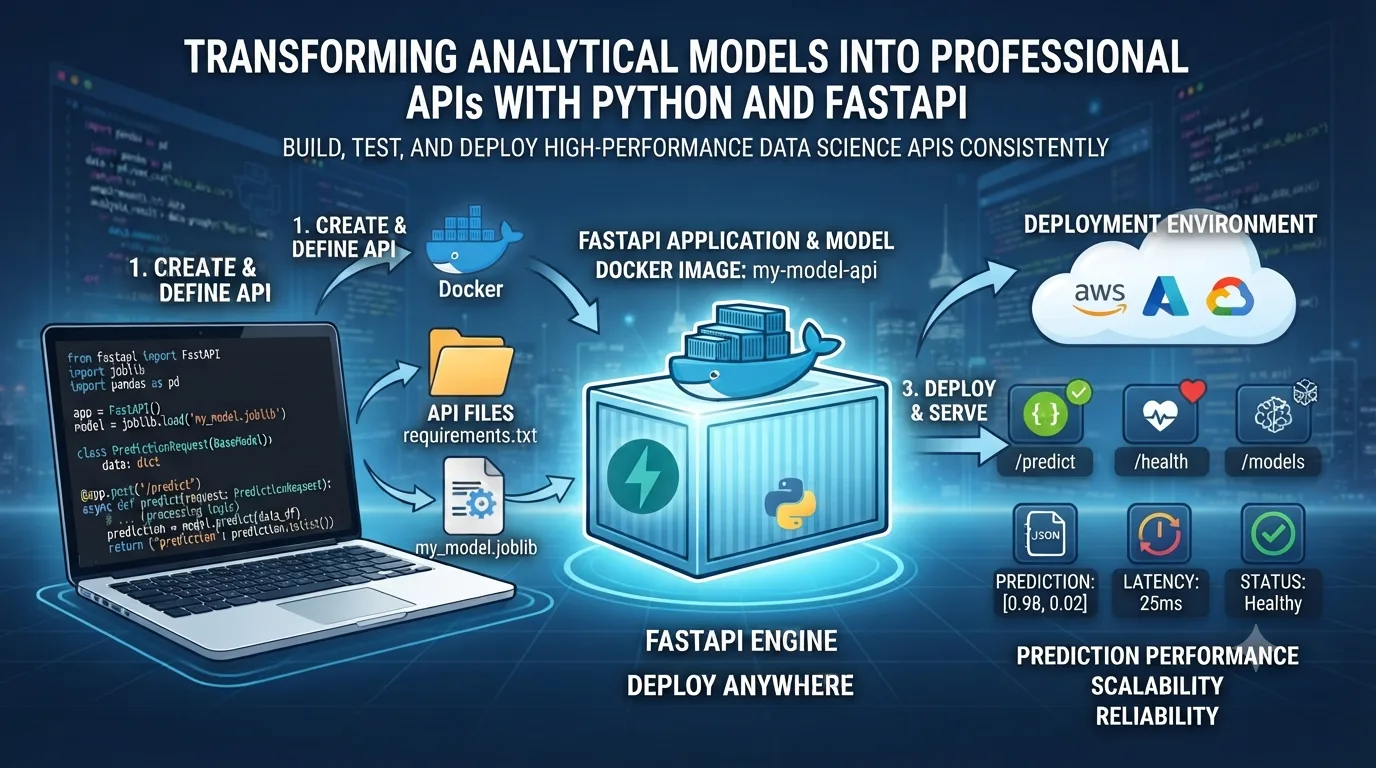
Biến Mô Hình Phân Tích Thành API Chuyên Nghiệp Với Ngôn Ngữ Python Và FastAPI
Trong thế giới phát triển phần mềm hiện đại, ngôn ngữ Python đã khẳng định vị thế độc tôn trong lĩnh vực khoa học dữ liệu, trí tuệ nhân tạo và xử lý thông tin lớn. Tuy nhiên, việc xây dựng một thuật toán hoặc mô hình phân tích xuất sắc trong môi trường nghiên cứu chỉ mới là bước khởi đầu. Thách thức thực sự nằm ở việc làm sao để đưa mô hình đó ra môi trường sản xuất (production) và phục vụ hàng triệu người dùng cuối thông qua các dịch vụ web ổn định. Đây chính là lúc FastAPI trở thành công cụ tối ưu cho lập trình viên nhờ tốc độ xử lý siêu việt, cú pháp hiện đại và khả năng tự động tạo tài liệu kỹ thuật vô cùng tiện lợi.
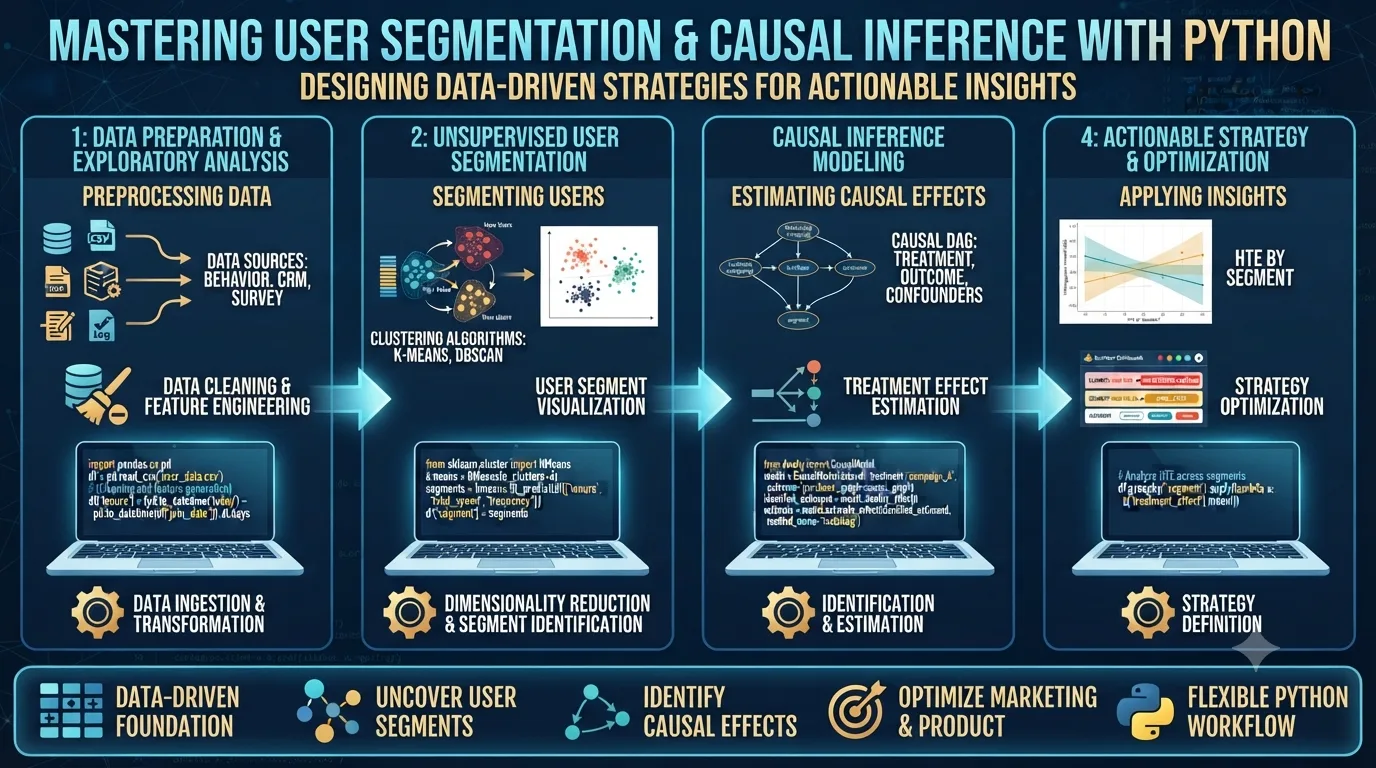
Bí Quyết Phân Khúc Người Dùng Và Phân Tích Nhân Quả (Causal Inference) Bằng Python
Trong kỷ nguyên số hóa, User Segmentation (phân khúc người dùng) đóng vai trò cốt lõi giúp các doanh nghiệp tối ưu hóa chiến dịch marketing và cải thiện trải nghiệm sản phẩm. Tuy nhiên, việc chia nhóm khách hàng thông thường chỉ giúp bạn nhìn thấy mối tương quan chứ không thể chứng minh được mối quan hệ nhân quả thực sự. Liệu tính năng mới thực sự làm tăng tỷ lệ giữ chân khách hàng, hay chỉ vì nhóm người dùng đó vốn đã có thói quen sử dụng tích cực từ trước? Để giải quyết bài toán này, Causal Inference (phân tích nhân quả) thông qua phương pháp Propensity Score Matching (PSM) kết hợp cùng ngôn ngữ Python chính là chìa khóa vàng giúp doanh nghiệp đưa ra quyết định chính xác.
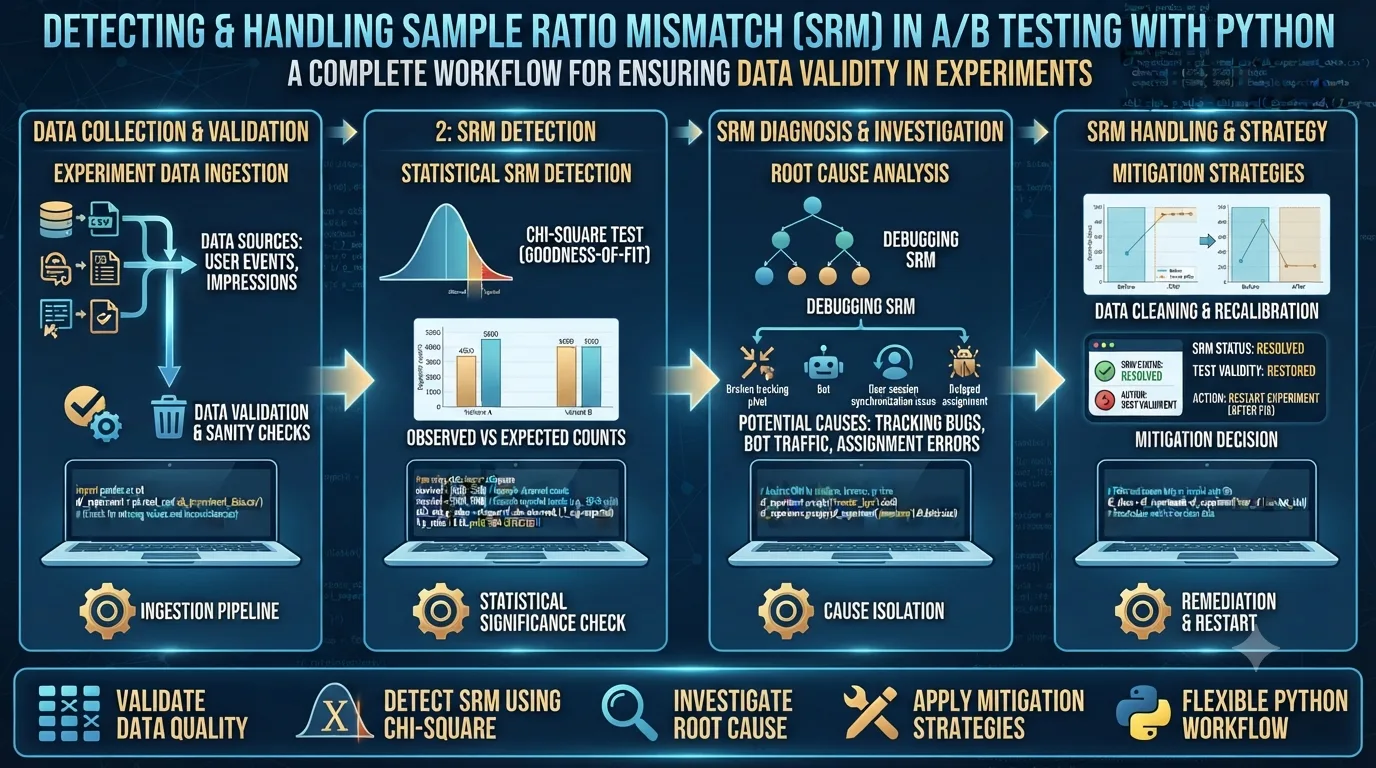
Bí quyết phát hiện và xử lý Sample Ratio Mismatch (SRM) trong A/B Testing bằng Python
Trong quá trình chạy A/B Testing, việc phân chia lưu lượng người dùng không đều giữa các biến thể có thể làm hỏng toàn bộ kết quả phân tích. Hiện tượng này gọi là Sample Ratio Mismatch (SRM). Nếu bạn bỏ qua SRM, mọi quyết định dựa trên dữ liệu đều sẽ sai lệch nghiêm trọng. Bài viết này sẽ hướng dẫn bạn cách nhận diện và xử lý SRM hiệu quả bằng ngôn ngữ Python.
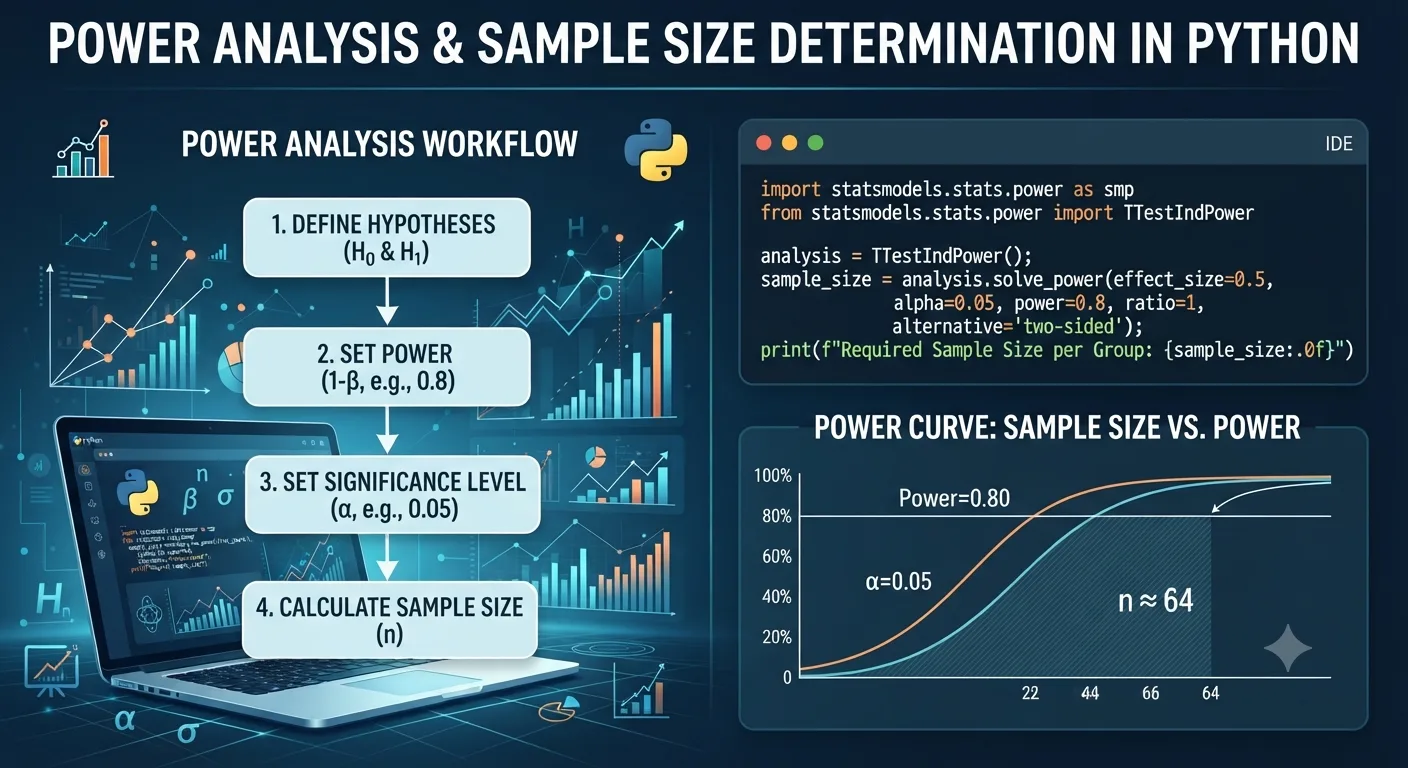
Bí Thuật Power Analysis Và Tính Cỡ Mẫu Chuẩn Xác Bằng Ngôn Ngữ Python
Trong nghiên cứu và phân tích dữ liệu hiện đại, Sample Size Calculation (tính toán cỡ mẫu) và Power Analysis (phân tích lực mẫu) là hai trụ cột thống kê quyết định độ tin cậy của mọi thí nghiệm. Việc tích hợp các phương pháp này bằng ngôn ngữ Python giúp tự động hóa quy trình xác định số lượng mẫu tối ưu, tiết kiệm chi phí tối đa và loại bỏ hoàn toàn các sai lầm thống kê do ước lượng cảm tính.
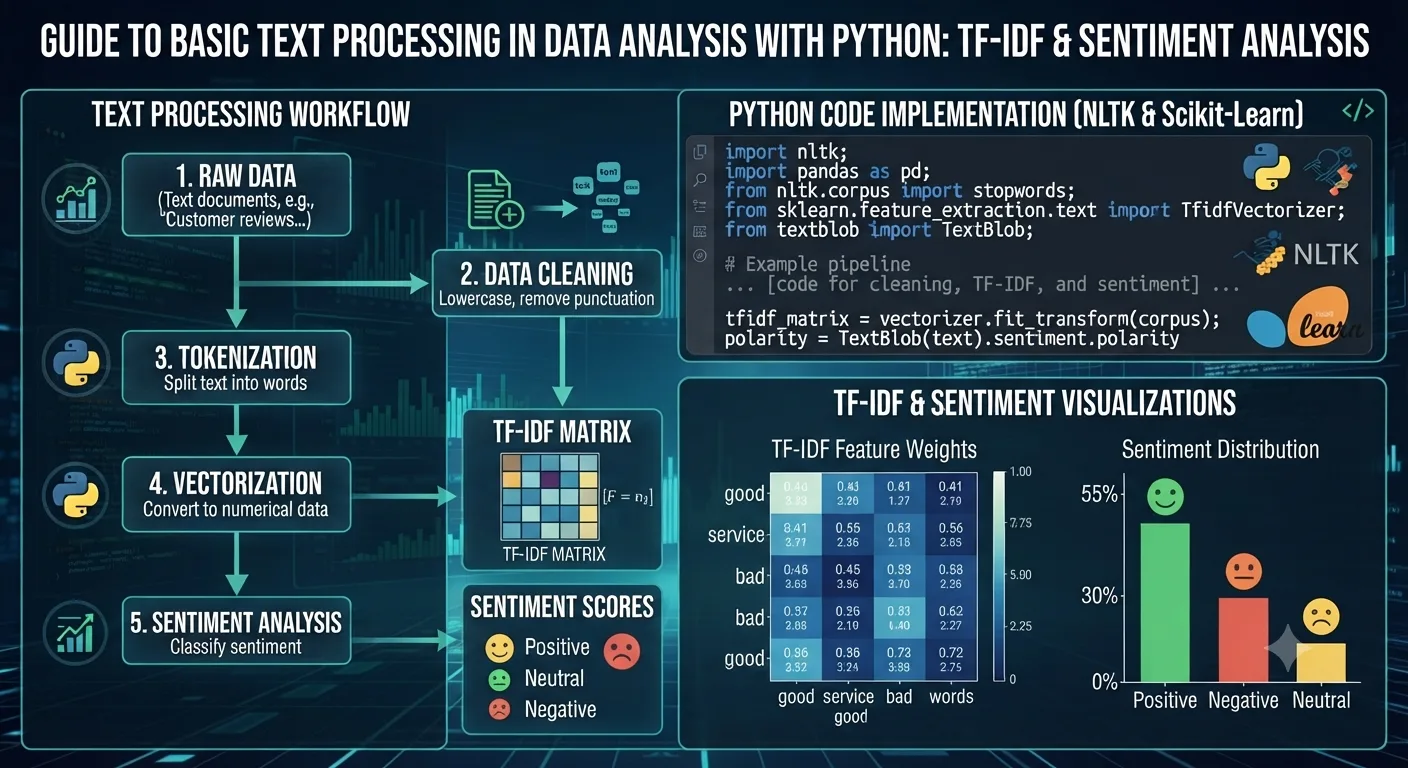
Hướng Dẫn Toàn Diện Xử Lý Văn Bản Cơ Bản Trong Phân Tích Dữ Liệu Với Python: TF-IDF Và Sentiment Analysis
Xử lý văn bản và khai thác dữ liệu phi cấu trúc đang trở thành kỹ năng cốt lõi trong phân tích dữ liệu hiện đại. Kho tàng thông tin từ mạng xã hội, đánh giá sản phẩm hay bài báo chứa đựng giá trị khổng lồ nếu bạn biết cách chuyển đổi chúng thành dạng số liệu mà máy tính hiểu được. Bằng cách sử dụng Python, bạn có thể dễ dàng xây dựng một pipeline hoàn chỉnh từ bước làm sạch dữ liệu văn bản, áp dụng mô hình TF-IDF cho đến Sentiment Analysis (phân tích cảm xúc) cơ bản.
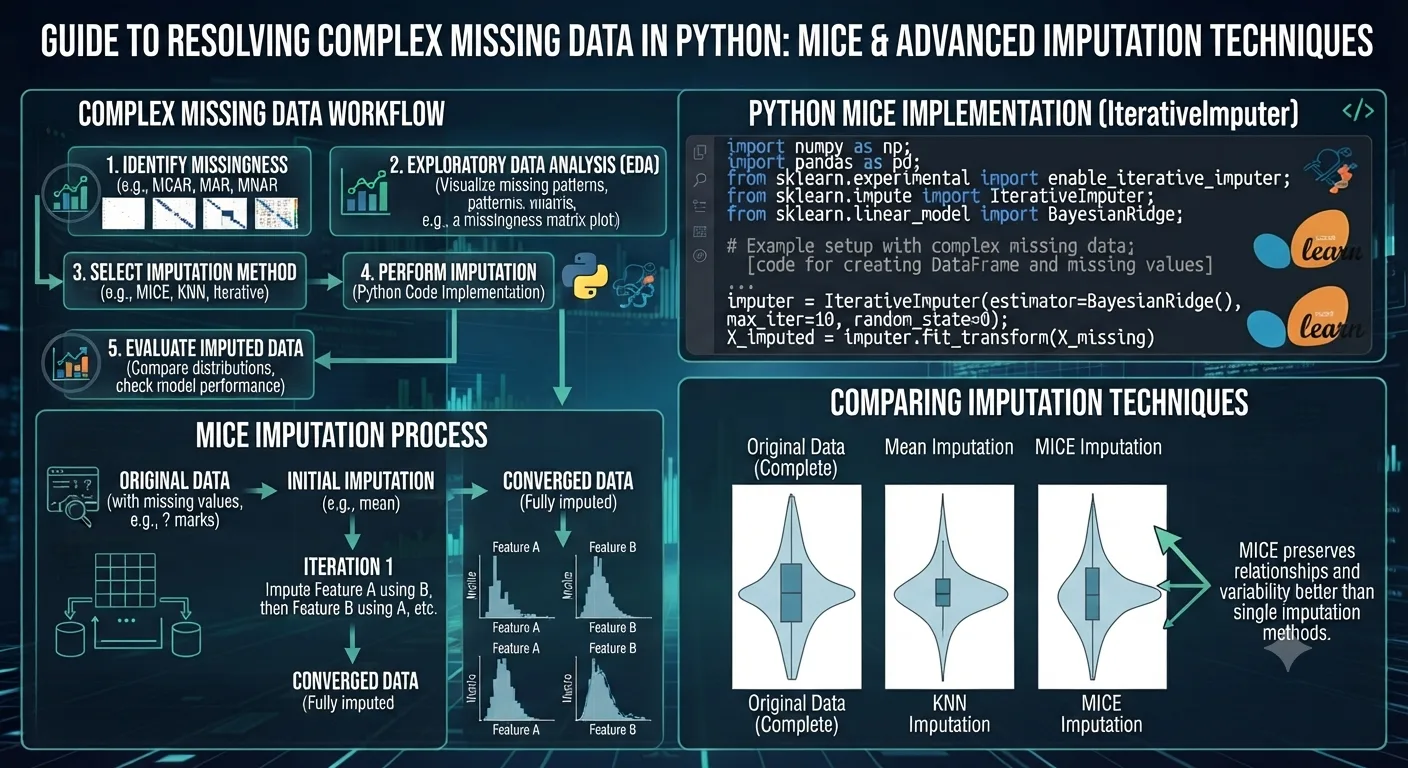
Khắc Phục Dữ Liệu Khuyết Thiếu Phức Tạp Trong Python: Bí Quyết Sử Dụng Kỹ Thuật MICE Và Imputation Nâng Cao
Trong thực tế khoa học dữ liệu, việc thu thập dữ liệu hiếm khi hoàn hảo. Các tập dữ liệu lớn thường xuyên đối mặt với tình trạng dữ liệu khuyết thiếu (missing data) do lỗi hệ thống, sai sót trong quá trình nhập liệu hoặc người dùng từ chối cung cấp thông tin. Nếu bỏ qua hoặc xử lý thô sơ, mô hình học máy của bạn sẽ bị chệch hướng nghiêm trọng. Việc nắm vững các imputation techniques (kỹ thuật điền khuyết) nâng cao, đặc biệt là phương pháp MICE, bằng ngôn ngữ Python là chìa khóa sống còn để bảo vệ chất lượng mô hình.
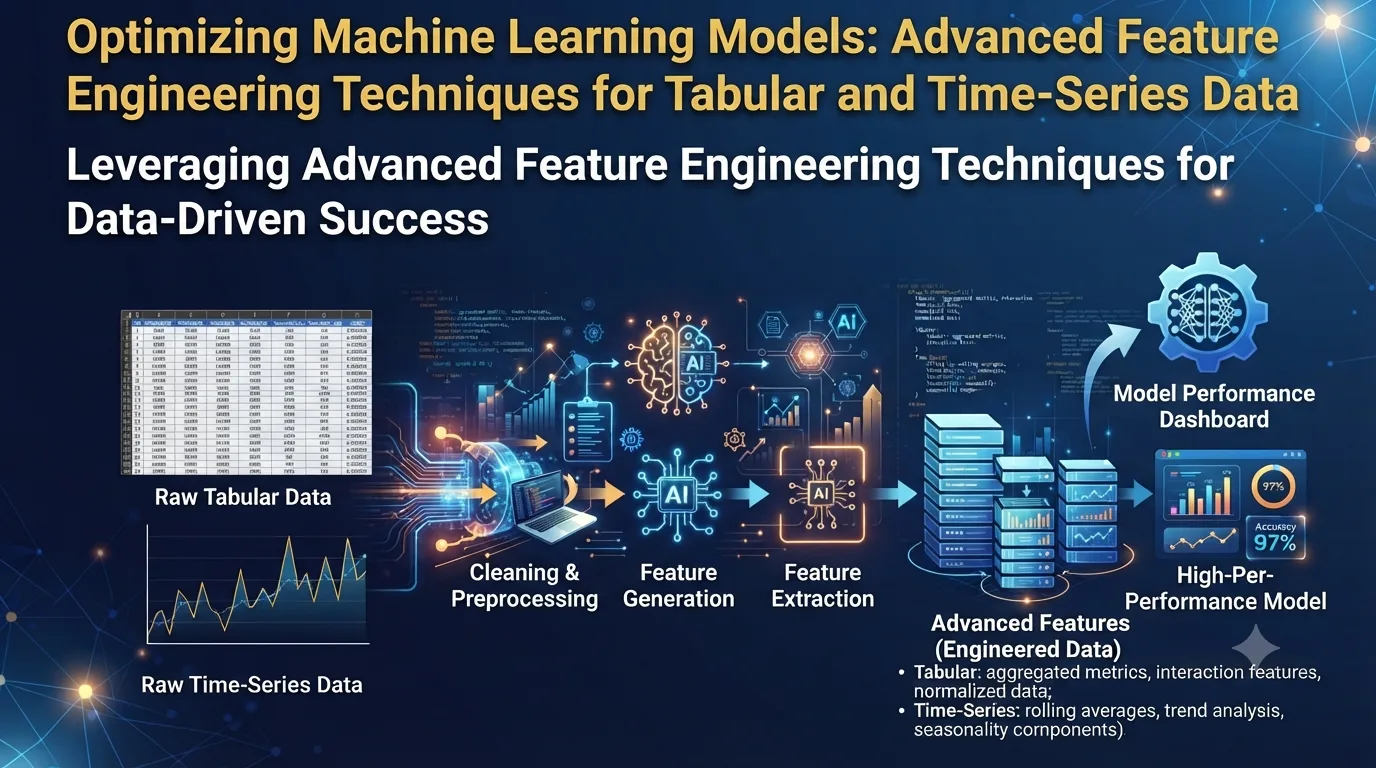
Tối Ưu Hóa Mô Hình Machine Learning: Kỹ Thuật Tạo Biến (Feature Engineering) Nâng Cao Cho Dữ Liệu Bảng Và Thời Gian
Trong thế giới khoa học dữ liệu, thuật toán xuất sắc đến đâu cũng trở nên vô nghĩa nếu đầu vào là dữ liệu kém chất lượng. Quá trình Feature Engineering (tạo biến đặc trưng) chính là nghệ thuật biến dữ liệu thô thành những tín hiệu sắc bén, giúp các mô hình học máy đạt độ chính xác tối đa. Đối với dữ liệu dạng bảng và chuỗi thời gian, việc khai thác sâu các mối quan hệ ẩn giấu sẽ quyết định sự thành bại của một hệ thống dự báo.
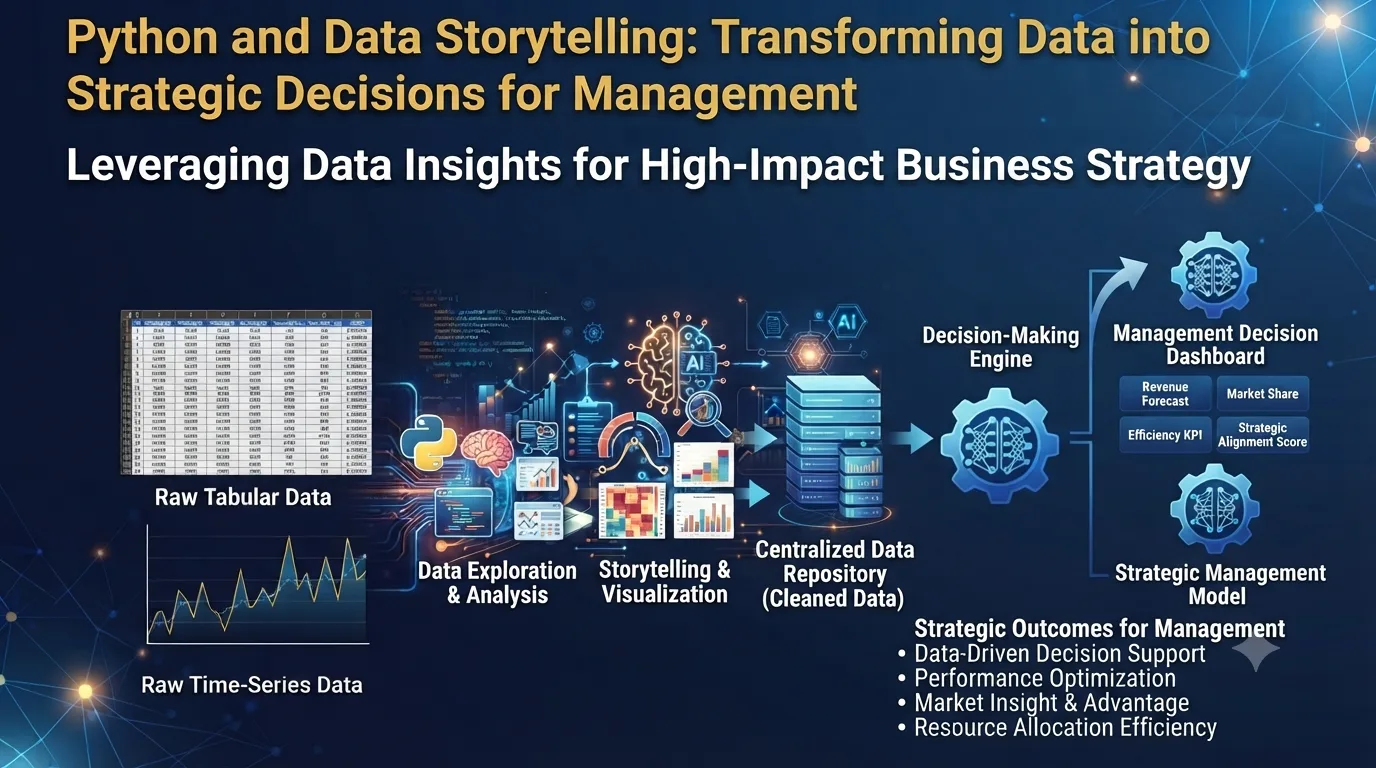
Python và Data Storytelling: Bí Quyết Biến Dữ Liệu Thành Quyết Định Chiến Lược Cho Cấp Quản Lý
Trong kỷ nguyên số hóa hiện nay, các doanh nghiệp đang chìm đắm trong biển dữ liệu khổng lồ. Tuy nhiên, dữ liệu thô dù lớn đến đâu cũng chỉ là những con số vô hồn nếu thiếu đi khả năng kết nối, giải thích và truyền tải. Đó là lúc Data Storytelling (kể chuyện dữ liệu) kết hợp cùng ngôn ngữ Python trở thành vũ khí sắc bén giúp cấp quản lý định hình các quyết định chiến lược chính xác, nhanh chóng và hiệu quả.
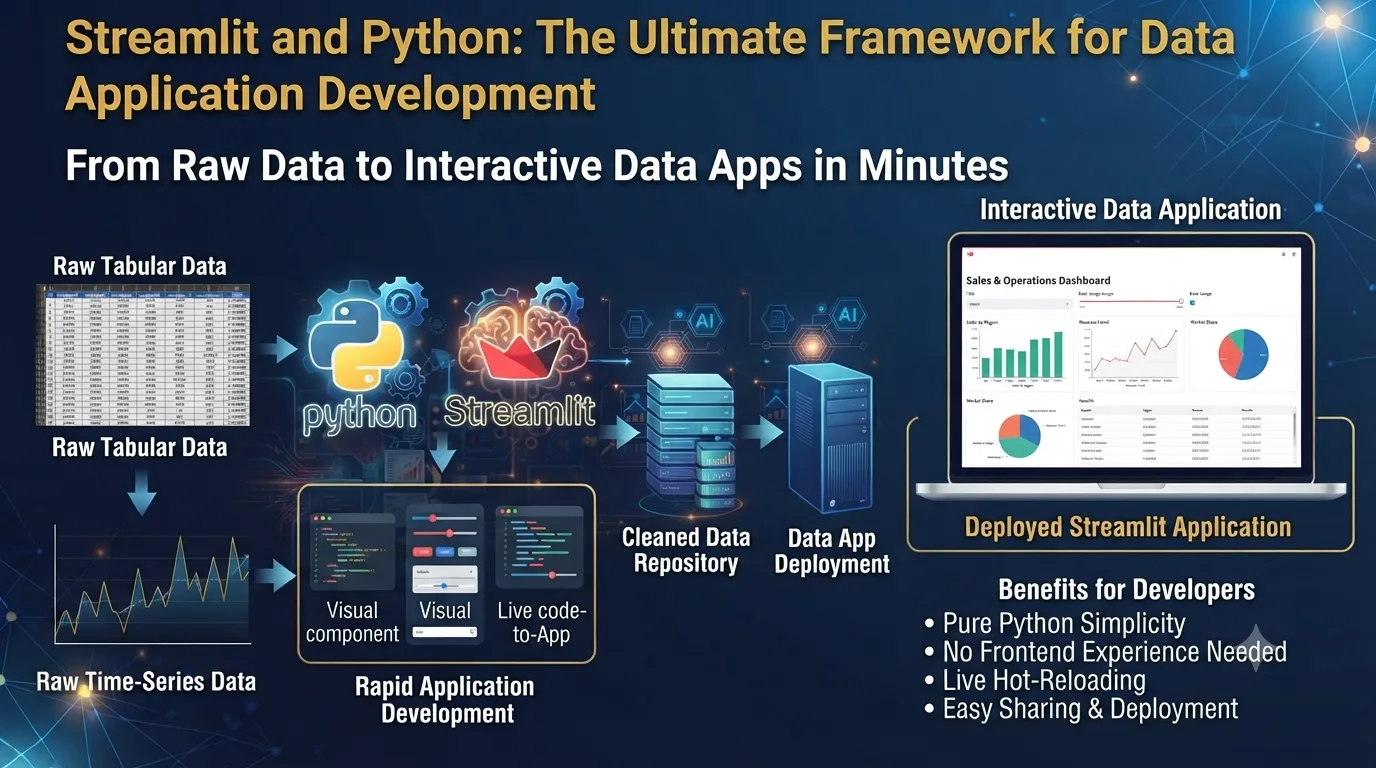
Xây Dựng Web App Phân Tích Dữ Liệu Trong 10 Phút Với Streamlit & Python: Hướng Dẫn Chi Tiết
Trong kỷ nguyên số hóa, phân tích dữ liệu (Data Analysis) đã trở thành kỹ năng cốt lõi giúp doanh nghiệp đưa ra quyết định dựa trên dữ liệu thực tế. Tuy nhiên, việc chuyển đổi các báo cáo trên Jupyter Notebook hay tệp Pandas DataFrame thành một ứng dụng web trực quan, tương tác cao để chia sẻ với sếp hoặc khách hàng thường mất rất nhiều thời gian. Bạn sẽ phải đối mặt với HTML, CSS, JavaScript hay các web framework phức tạp như Django/Flask.
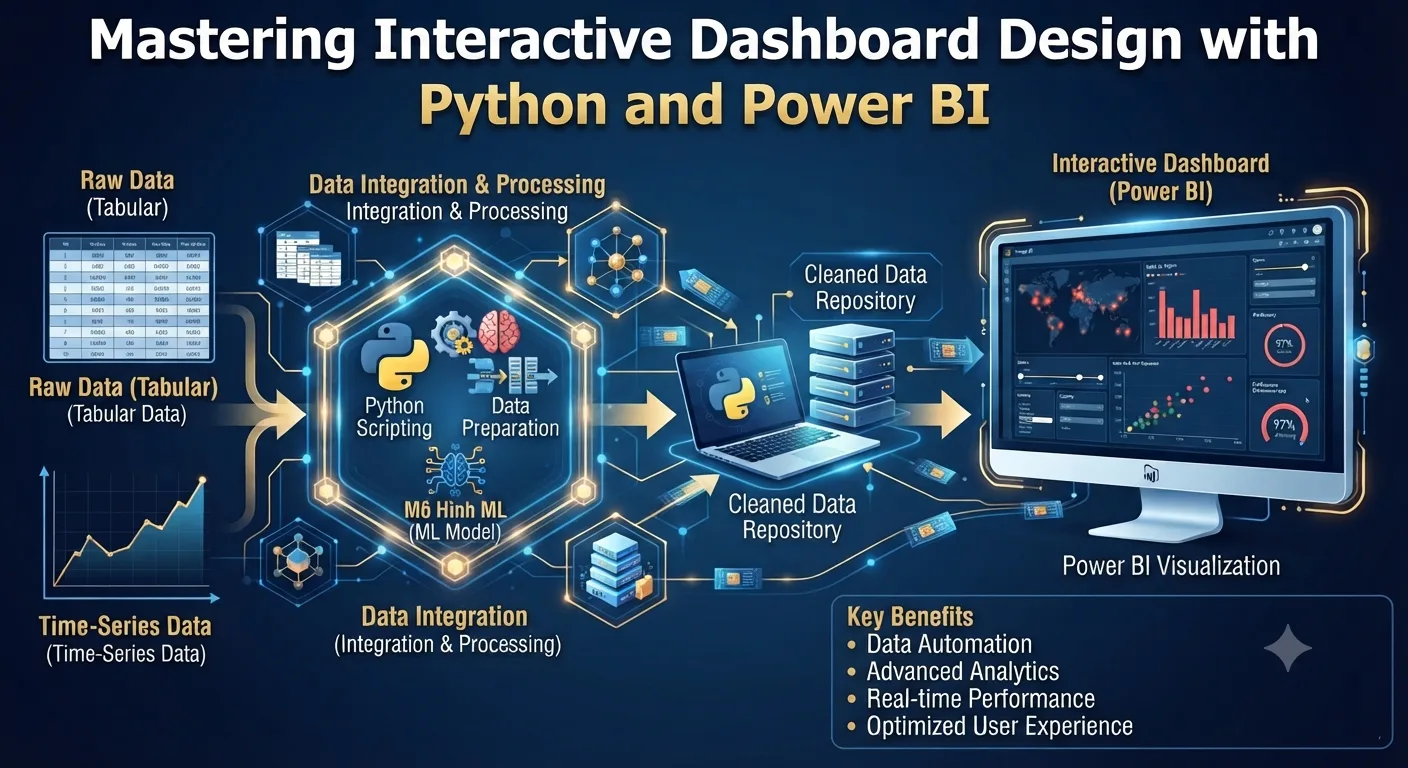
Bí quyết thiết kế Dashboard tương tác đỉnh cao với Python và Power BI
Trong kỷ nguyên dữ liệu số, việc chuyển đổi các con số thô thành thông tin trực quan là yếu tố then chốt giúp doanh nghiệp đưa ra quyết định chính xác. Thiết kế Dashboard tương tác không chỉ đòi hỏi tính thẩm mỹ cao mà còn cần sự tối ưu về hiệu suất kỹ thuật và trải nghiệm người dùng (UX). Khi kết hợp sức mạnh xử lý dữ liệu linh hoạt của ngôn ngữ Python cùng các nền tảng phân tích hàng đầu như Tableau hoặc Power BI, các nhà phát triển và phân tích dữ liệu có thể tạo ra những hệ thống báo cáo đỉnh cao, đáp ứng mọi yêu cầu khắt khe từ phía doanh nghiệp.
